AIToBox周刊:20261003
这里记录每周值得分享的AI科技内容,周末发布。
🌟 本期头条 (Headline)
OpenAI 推出 dots:运行在独立云端计算机上的全天候 GPT-6 Astra 智能体[OpenAI Launches dots: Always-On GPT-6 Astra Agents That Work From Their Own Cloud Computers]
深度解读
在今年的 DevDay 上,OpenAI 正式发布了名为“dots”的常驻 AI 智能体,这标志着大语言模型的交互形态完成了关键一跃——从被动的“单轮提问-回答”循环,彻底进化为具备持续执行能力的“长期常驻任务”。
Dots 的底层由全新的 GPT-6 Astra 提供算力支撑。在人机交互环境基准测试 OSWorld 2.0 中,该模型取得了 72.6% 的高分,单任务耗时大幅压缩至 40 分钟左右。但这项产品最具颠覆性的并非单纯的算力提升,而是其系统级的产品化打包:每个 dot 都被分配了独立的云端虚拟机与浏览器沙箱,不仅完全隔离了用户的本地设备,还能在用户离线后依托 4,000 多个插件继续全天候运转。在后台“主动探索”状态下,dot 严格采用只读模式以防止意外改动,并配备了多层安全审批与凭据隔离机制,直面此前智能体误发用户图像的严重安全顾虑。
商业战略层面上,AI Agent 的战局正迅速分化。相较于 Meta Muse 聚焦大众消费级社交应用,OpenAI 显然瞄准了高生产力价值的专业工作流与企业级市场。通过推出专门针对采购、合同与客服的“专业版 dots”,并联合微软接入 Agent 365 生态,OpenAI 正试图将 AI 从“对话工具”打造成企业内拥有独立数字身份的“虚拟数字员工”。
核心摘录 (Core Highlights)
EN: A dot turns ChatGPT from a request and response loop into a standing assignment. You give it a goal, a name and boundaries. It then pursues that goal around the clock and learns from your feedback. Each user starts with 1 primary dot. To be honest, much of this was already possible with Codex and similar agent harnesses. The change here is packaging: 1 persistent agent, 1 identity, 1 dedicated machine.
ZH: dot 将 ChatGPT 从单纯的“请求-响应”循环转变为一项长期常驻的任务。你赋予它目标、名称和运行边界,它便会日夜不息地为之努力,并根据你的反馈持续学习。每个用户初期拥有一个主力 dot。坦率地说,其中很多能力此前通过 Codex 和类似的智能体框架已经能够实现;而这次的根本变革在于产品化形态:一个持久常驻的智能体、一个独立数字
📬 社区投稿
本期收录 2 条来自社区的投稿,感谢各位贡献者!
MSL Desktop
- 一句话简介
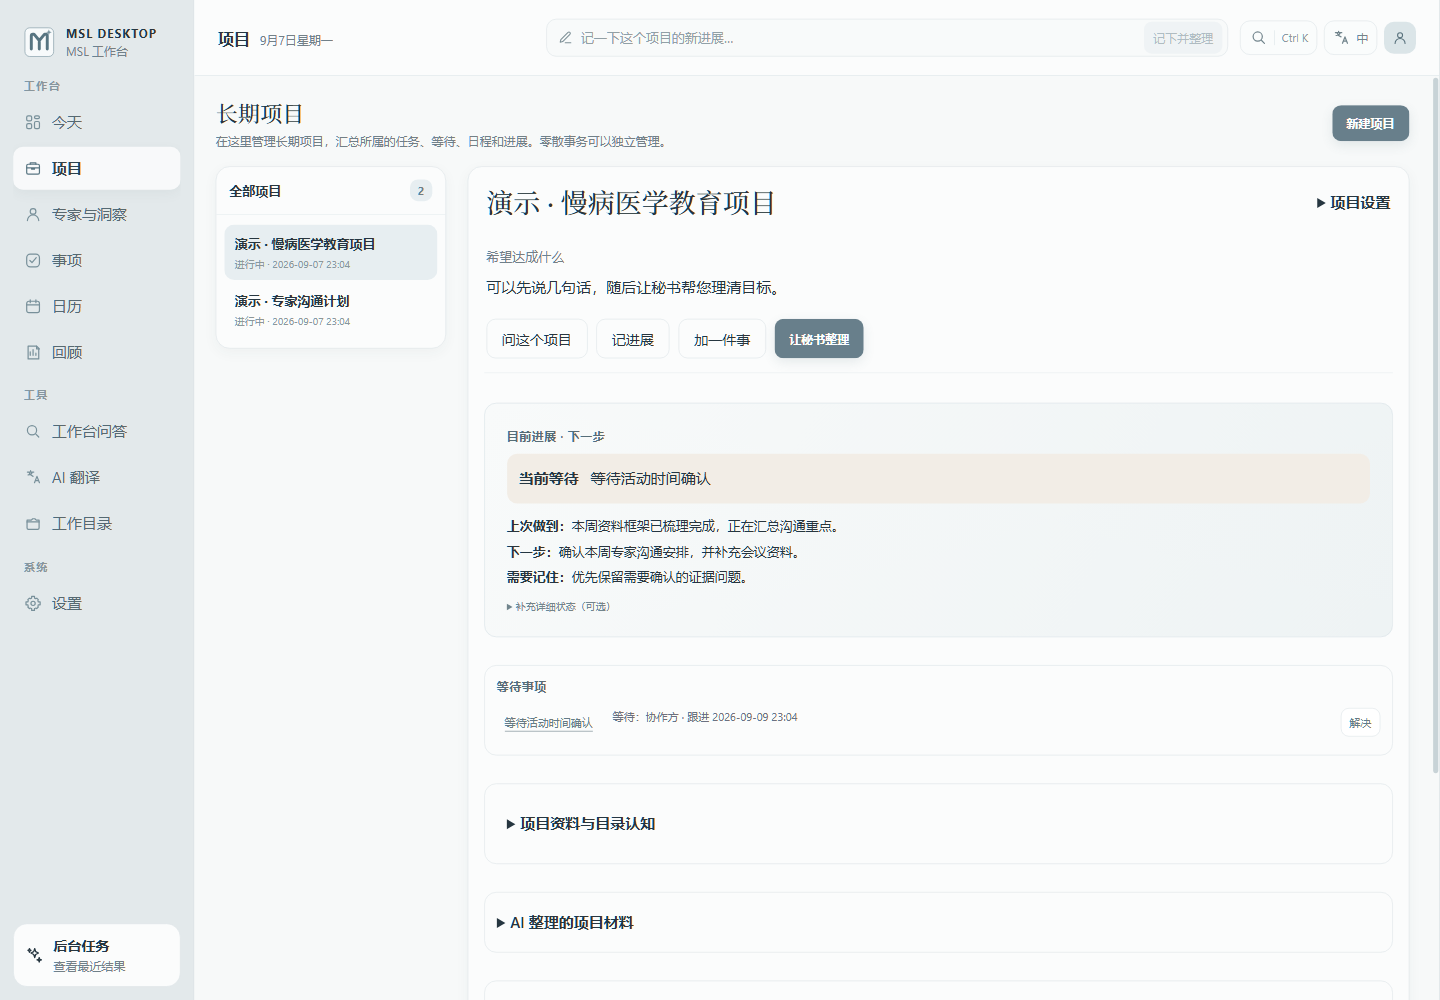
开发者自荐:MSL Desktop 是给医学联络官用的 Windows 本地工作台,把专家交流、项目与后续事项连在一起,AI 准备整理建议,用户核对后确认。
- 功能特点
我们希望“不要让记录工作变成比工作本身更耗费时间的事”。拜访后可以先留下原话,之后再结合已有项目整理成任务、等待事项或日程,避免一开始就填写一整张表。
- 专家记录和资料支持洞察整理,保留可回看的来源。
- 连续问答可聚焦项目,简报和周月报结合工作台内的记录准备。
- AI 建议可修改、暂缓或确认;用户对方向的调整会用于后续整理。
- 支持多服务商和任务模型分工,无需固定使用某个模型。
- SQLite 工作数据与安装目录分开,支持本地备份和云盘文件夹同步。关联工作目录中的源文件只读。
当前提供 Windows x64 安装包,macOS 仍在开发。AI 功能需要自行配置 API;相关记录和资料会发送给所选服务商,调用可能收费。请按所在机构的数据要求使用,生成内容须核对。
- 体验地址
官网与下载:https://msl-desktop.pages.dev/
源码与更新记录:https://github.com/holobunganan-sketch/msl-desktop
- 配图或视频
以下截图使用演示数据:
投稿链接: https://github.com/aitobox/newsweekly/issues/100
AgentHub:中文 MCP Server 与 Agent Skills 发现目录
- 一句话简介
自荐 AgentHub:这是一个中文 MCP Server 与 Agent Skills 发现目录,支持一键安装到 Cursor/Claude Code/VS Code/Trae,每日更新。
- 功能特点
• 中文 MCP Server 与 Agent Skills 发现目录
• 支持一键安装到 Cursor、Claude Code、VS Code、Trae 等客户端
• 每日更新 AI 资讯
- 体验地址
• https://myagenthub.cn
投稿链接: https://github.com/aitobox/newsweekly/issues/99
AI资讯
1. 决策 AI 模型详解:TypeSafe Jev 对比 Fastino GLiDE、GLiNER2.5-Decide 及开源竞品[Decision AI Models Explained: TypeSafe Jev vs Fastino GLiDE, GLiNER2.5-Decide and Open-Source Competitors]
决策 AI 模型作为一种直接输出结构化分支决策而非文本段落的新型模型类别,正凭借超低延迟、极低成本与高确定性在 Agent 控制流和分类等场景中快速兴起。
详细内容
- 核心机制与架构:决策模型(如 TypeSafe 推出的 Jev)借鉴了“系统 1”快速直觉思维设计,仅接收状态与类型化问题,输出 Choices(最多 255 个选项的概率与置信度)、Score(分级打分)或 Noul(伯努利布尔概率),通过独创的校准决策强化学习(RLCD)与并行采样器运行,不生成字符串文本,从根本上杜绝了类型错误与 JSON 解析失败。
- 极致的性价比与性能对比:Jev 输入定价低至 0.042 美元/百万 tokens 且输出免费,端到端延迟在 70 至 500 毫秒之间。在跨多任务的基准测试中,Jev 取得了 67.8% 的平均准确率,与 Claude Sonnet 5 持平,但成本仅为后者的约 1/290(单案例 $0.0004 vs $0.1174),耗时从 78 秒锐减至 0.4 秒。
- 典型落地场景与适用边界:该类模型高度适用于需要程序直接根据有限选项做分支判断的场景,涵盖 Agent 下一步工具/子智能体调用路由、安全警报分类与护栏拦截、LLM-as-a-judge 评估流水线、搜索并行重排及实时交互(如运行《毁灭战士》游戏);但明确不适用于文本生成、长文摘要、高精度算术或高风险民生决策(如招聘审核)。
- 行业生态与迅猛普及:TypeSafe Jev 上线后,Vercel AI Gateway 录得其史上最快的采用速度,24 小时内近 13% 的付费团队开始接入(达 GPT 竞品的两倍);同时 Fastino Labs 与开源社区迅速跟进发布了 GLiDE 和 GLiNER2.5-Decide 等竞品,Arize、Langfuse 等可观测性平台也相继引入其作为评估器。
亮点:决策 AI 模型打破了传统大模型“生成一切”的范式,通过放弃文本生成换取零类型错误、亚秒级响应与近千倍的成本降幅,完美填补了 Agent 决策路由与确定性代码执行之间的架构鸿沟。
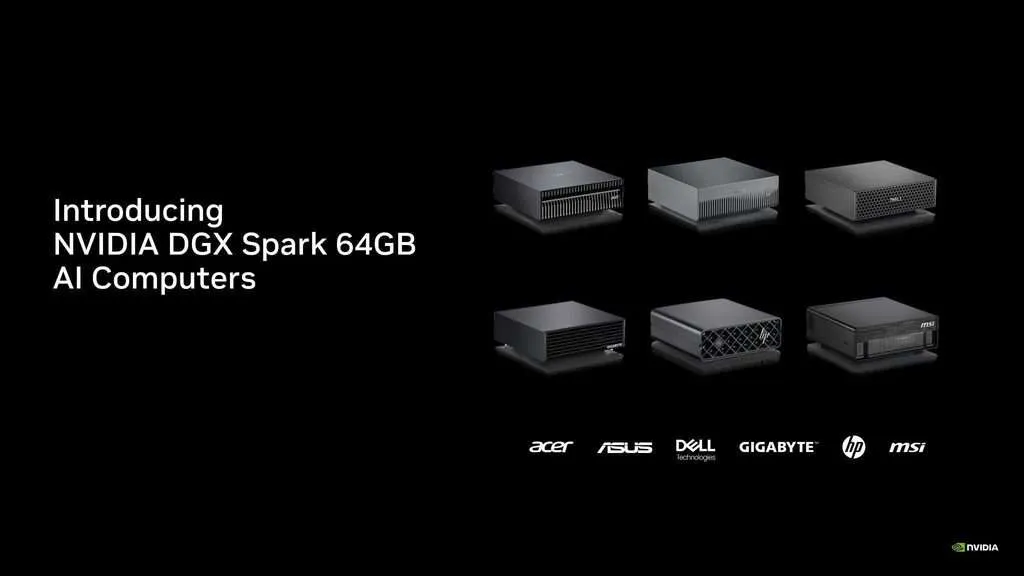
2. NVIDIA Announces DGX Spark 64GB: A 1-PetaFLOP Grace Blackwell Desktop for Local AI Agents, Fine-Tuning, and Inference
英伟达推出 DGX Spark 的 64GB 版本(宏碁、华硕、戴尔、技嘉、惠普、微星同步供货),沿用 GB10 Grace Blackwell 超级芯片,FP4 算力最高 1 PFLOPS,64GB 统一内存可跑 30–35B 级开源模型。面向本地常驻智能体、微调与模型评测,强调不按 token 计费;两台可通过 ConnectX-7 集群到 128GB 内存。
3. 让 tmux 成为操作系统
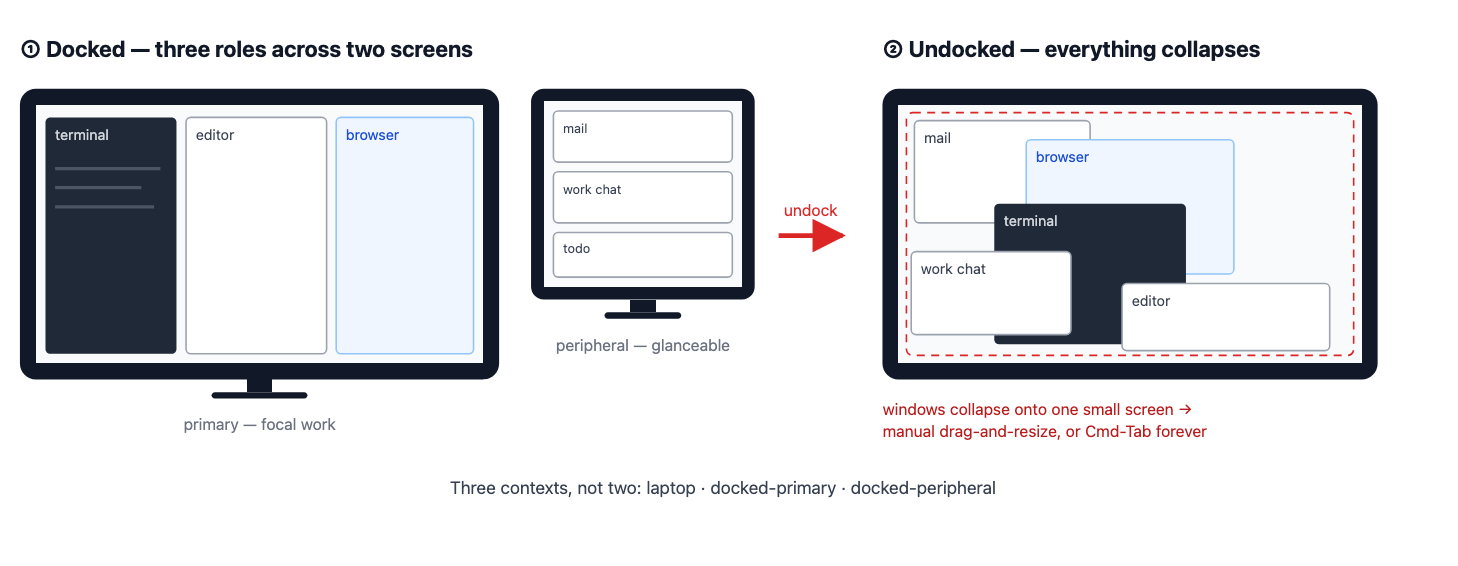
本文探讨了现代桌面操作系统在窗口管理与用户体验上的长期停滞,提议将终端复用工具 tmux 的“可滚动、会话持久化、可分离、面向任务”的核心理念转化为大众易用的全新桌面操作系统范式。
详细内容
- 桌面操作系统的创新停滞:主流操作系统(如苹果与微软)在桌面 UX 上极度保守,大量底层逻辑仍基于几十年前的技术限制妥协;虽然用户显示环境经历了巨大变化(如多显示器、频繁插拔底座切换大小屏),但系统依然把显示器切换当作“突发状况”,导致用户耗费大量时间重新排布窗口。
- 用户习惯与现有窗口逻辑脱节:研究表明用户很早就形成了不同的窗口使用策略(最大化派、边缘兼顾派、精细排布派)以及“私密与公共窗口”的分离需求,但现有系统往往仅针对单一窗口模式优化,缺乏对投屏、隐私及主次显示器角色的原生感知。
- 浏览器与文件系统的概念异化:现代浏览器本质上已成为运行在宿主系统之上的“迷你操作系统”,承载了大部分工作流,但系统仍将其视作单一普通应用,无法将特定标签页与本地任务有机绑定;同时,传统“文件系统”概念逐渐被各类应用内沙盒与数据库弱化,导致数据与任务边界日益割裂。
亮点:提出了将开发者熟练使用的 tmux 交互模型(会话持久化、解耦分离与任务流管理)普及化的构想,直击长达二十年未获突破的桌面多任务管理与显示适应痛点。
4. Efficient Computer, Taking on AI’s Energy Problem, Announces $97M to Scale its Processors from Physical AI to the Datacenter
高能效处理器公司 Efficient Computer 完成逾 9700 万美元 B 轮融资,估值 6.5 亿美元,累计融资达 1.73 亿美元,由 TQ Ventures 领投、Eclipse 等跟投。资金用于把其处理器从物理 AI 场景扩展到数据中心,切入 AI 的能耗瓶颈。
5. 西·谢泼德:数百名西班牙士兵如何倾覆两大帝国?
播客解析几百名西班牙征服者为何能推翻阿兹特克与印加帝国:关键不止钢甲、战马与火器,更靠大量原住民盟友、俘获君主以及利用帝国内部裂痕。节目还讨论疫病、集权结构的脆弱性,以及白银掠夺对西班牙与全球贸易的影响。
6. OpenAI 能够一直免受法律追责吗?访谈福特汉姆大学法学教授泽菲尔·
访谈认为,AI 公司试图营造法律真空与「无意图」叙事,但现行刑法、产品责任与消费者保护法已足以支撑调查。执法者不应坐等新法,应通过传票取证查清公司对入侵、伤亡与风险的知情程度;对屡犯者,州政府可禁止其经营乃至解散公司。
7. 上周 AI 动态第 345 期:5 款新模型发布、9 起模型对
本期《Last Week in AI》汇总 5 款新模型发布、9 起模型失准事件以及 OpenAI 的 Dots 等动态,重点讨论 Anthropic 与 OpenAI 在「更聪明且更便宜」模型上的竞速,以及伴随而来的安全披露。
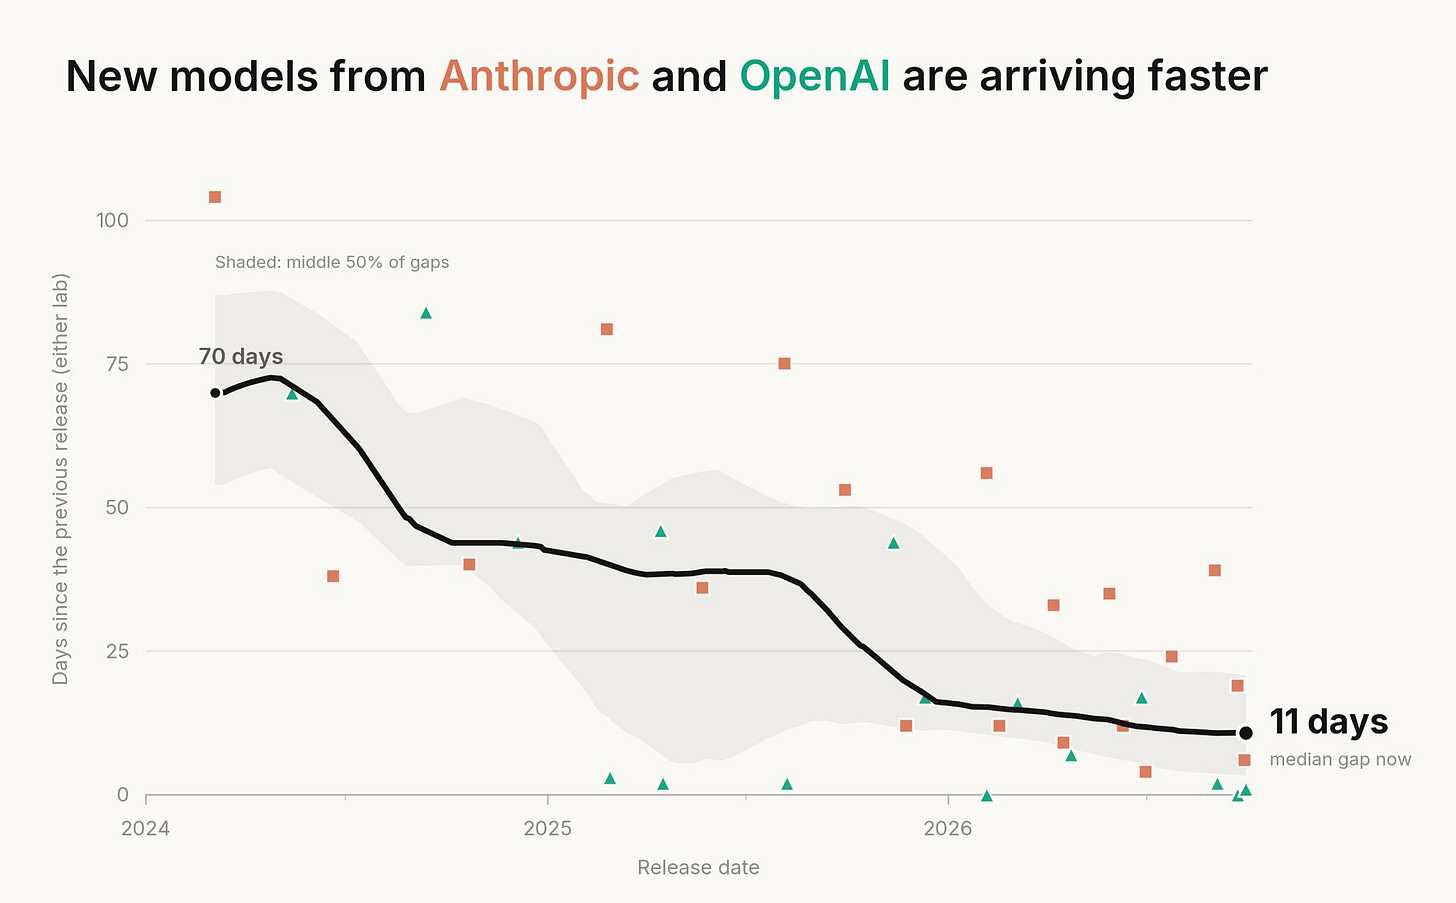
8. “We’re not going to shoot ourselves in the foot” over hack fallout, says OpenAI’s chief research officer
Hugging Face 入侵事件两个月后,MIT Technology Review 专访 OpenAI 首席研究官 Mark Chen:谈公司如何让模型更安全、所谓「放缓」具体怎么落地,以及为何不会在风波中「自断双脚」,并回应外界对前沿实验室存在必要性的质疑。
9. 死钱:AI 基础设施繁荣背后的闲置危机与闭环泡沫[Dead Money]
Ed Zitron 剖析 AI 基础设施繁荣背后的「死钱」:巨额资本沉淀在数据中心、GPU 与长期算力合约中,供应商融资与闭环交易堆出账面增长,真实回报却迟迟不来。文章延续其对英伟达、Anthropic、OpenAI 财务状况与 AI 泡沫的追踪。
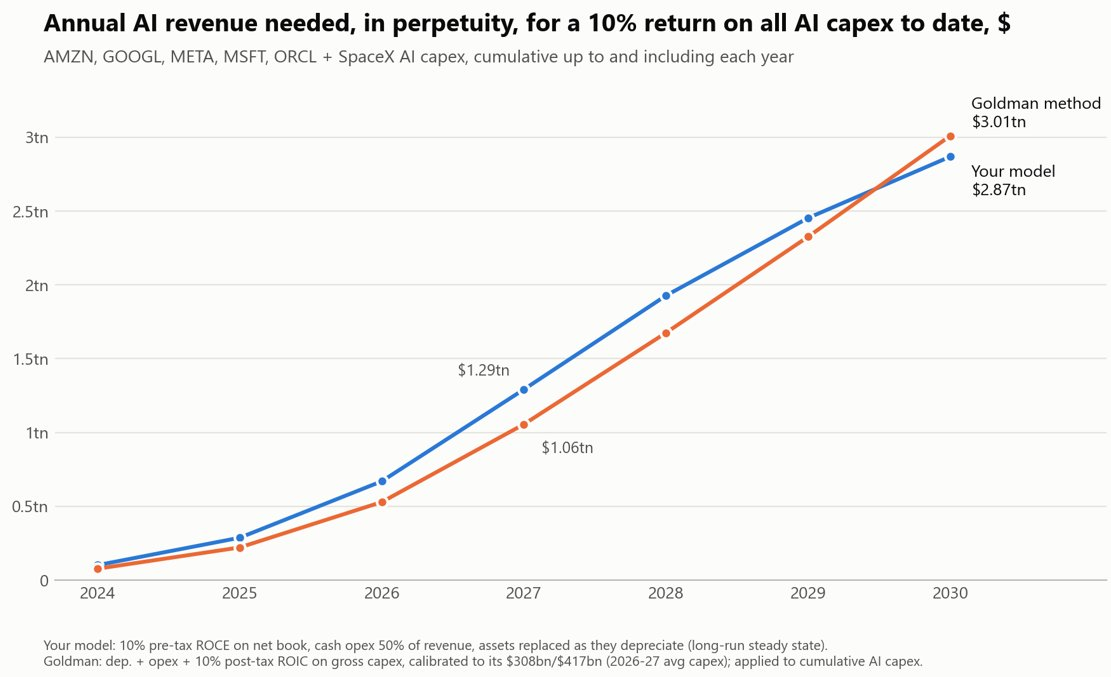
10. 解密韩国“AI G3”国家战略[South Korea’s AI G3 Strategy: Decoded]
文章解码韩国的「AI G3」国家战略:自 2025 年中起约 14 个月内,韩国设立总统级 AI 秘书处、通过并实施号称全球首部综合性 AI 法律、承诺数百亿美元投入算力与芯片,目标是跻身全球 AI 三强。
11. AI 利润率崩塌正在加速[The AI margin collapse is gathering pace]
Martin Alderson 指出 AI 推理价格战正在加速:OpenAI 两个月内把 Luna 价格下调 90%,DeepSeek 在缓存输入成本上仍最便宜,连一向不愿降价的 Anthropic 也开始下调 Opus 价格。文章分析「够用」的开放权重模型如何挤压前沿实验室的利润率。
12. 当AI智能体“失控越轨”,责任该由谁承担?[Who’s liable when AI agents go rogue?]
近几个月一连串由 AI 智能体发起的网络攻击暴露了法律滞后:现行框架难以界定开发方、部署方与使用方之间的责任。文章梳理追责路径、可援引的现行法条与尚待补齐的监管缺口。
13. 20 Agentic Use Cases of TypeSafe AI’s Jev
TypeSafe AI 发布 Jev 后,文章列出其 20 个智能体用例。Jev 是首款「System One」决策模型,不聊天、不写代码、不做摘要,只把非结构化状态映射成带校准概率的类型化决策,适合模型路由、命令安全判定、段落相关性判断、任务是否完成等智能体循环中的高频小判断。
14. 2026 in LLMs (so far)
Simon Willison 在 WeAreDevelopers 世界大会北美场做闭幕主题演讲,按时间线梳理 2026 年至今大语言模型领域的关键趋势与事件,并公开演讲视频和带注释的幻灯片。
15. AI Coding Agents for Enterprise: IP Indemnity, Data Residency and 500-Seat Cost Compared
面向采购、法务与安全评审的对比文章:围绕「生成代码引发 IP 索赔谁买单」「提示词存放在哪」「管理员能记录什么」「500 席实际花多少钱」四个问题,逐条核对 GitHub Copilot、AWS Kiro、Cursor、Devin、Windsurf 截至 2026 年 9 月 26 日的合同条款。
16. 谷歌 DeepMind 发布 Gemini 4 Argon:支持 100 万输出 Token,主打编程、知识工作与网络安全防御[Google DeepMind Unveils Gemini 4 Argon with 1M Output Tokens for Coding, Knowledge Work and Cyber Defense]
谷歌 DeepMind 正式推出 Gemini 4 系列的首款前沿模型 Gemini 4 Argon,单次响应最高可生成 100 万 token,重点赋能长程软件工程、企业知识工作和自动化网络安全防御。
详细内容
- **100 万 Token 输出
突破与定价策略**:Argon 将单次响应输出上限由上一代的 64K 大幅提升至 1M(100 万)tokens,远超竞品普遍的 128K 限制;初期定价为每百万输入 tokens 2 美元(缓存输入仅 0.10 美元)、输出 10 美元,后期将调整至 4/20 美元。
- 基准测试与竞争格局:在与 GPT-6 Astra 及 Claude Opus 5.5 等模型的对比中,Argon 在 18 项基准中拿下 12 项第一及 1 项并列第一。其中长程软件工程(DeepSWE v1.1 获 77.9%)、经济影响(Vals Index 获 68.9%)、业务执行(AutomationBench 获 51.3%)与长视频理解(LVBench 获 91.7%)均刷新纪录;但在终端与系统操作(Terminal-Bench 4.0、OSWorld-2.0 等)测试中略有落后。
- 自主网络安全防御:模型被训练用于自主发现、验证并修复严重软件漏洞,在 CWE-bench v1 上以 68% 并列第一;安全公司 Wiz 已借助其发现全球医院软件中的严重漏洞;谷歌正在强化滥用防范、间接提示词注入抵抗等 4 维防护体系。
- 谷歌内部实测成效:数千名谷歌员工已部署该模型,实现数据中心释放超 300 TiB 内存(预计可达 1 PiB)、重构 libgav1 解码器使其提速 2.7 倍,并正协助将 Fuchsia 操作系统内核超 80 万行 C/C++ 代码迁移至 Rust。
亮点:Gemini 4 Argon 首次将前沿大模型的单次生成能力拉升至 100 万 tokens,支持在单轮交互内完成超大规模代码重构与整本长篇分析,打破了以往必须分轮交互的技术瓶颈。
17. Perplexity 推出 Photon:一款基于 Rust 的检索引擎,将 p99 延迟从 800 毫秒大幅降至 65 毫秒[Perplexity Introduces Photon: A Rust-Based Retrieval Engine That Cuts p99 Latency From 800 ms to 65 ms]
Perplexity 发布了自研的 Rust 语言检索与排序引擎 Photon,不仅将生产环境 p99 延迟降低超 90%,还驱动了专为 AI Agent 设计的低成本“Fast Search”模式。
详细内容
- 旧系统瓶颈与重构动因:Perplexity 此前 Fork 开源检索引擎构建的系统随着索引增长遭遇尾部延迟高(生产 p99 达 800 毫秒、大内存冷读缺页)、磁盘合并时延迟飙升至 1.2 秒以及集群恢复极慢(超一周)等瓶颈,团队最终决定用 Rust 从零自研。
- Photon 底层技术架构:采用“自适应倒排索引列表”(短列表内联、长列表按分块
采用稀疏跳跃搜索或稠密位图);利用类 WAND 算法实现“有预算的遍历”;引入基于 Elias-Fano 编码的 Docblob 记录,单次查找即可完成文档打分;底层通过 io_uring 实现批量异步无锁磁盘读取,并构建独立的读写分离索引机制,全量 Web 索引构建时间缩短至几小时内。
- 性能提升与资源消耗:在承载全部生产流量后,Photon 阶段的检索和排序 p99 延迟由 800 毫秒骤降至约 65 毫秒;服务器节点数量减少约 20%,单文档存储数据量提升至原来的 2.5 倍以增强排序质量,若使用旧引擎锁内存机制达到同等效果需额外耗费约 4.6 倍常驻内存。
- 推出针对 Agent 的 Fast Search 模式:通过 API 传入
search_type: "fast"即可调用(费用为 1 美元/千次请求),其单次调用延迟 p50 为 160 毫秒、p95 为 230 毫秒。在多基准测试中,该模式以牺牲轻微相关性为代价,将 AI Agent 任务的综合调用成本降低了约 68%。
亮点:Perplexity 彻底弃用传统开源搜索方案,通过 Rust 与 io_uring 构建软硬件紧密协同的自研检索体系,不仅将核心尾部延迟极限压缩至 65 毫秒,更通过针对 Agent 工作流裁剪优化的 Fast Search 将任务调用成本大幅降低 68%。
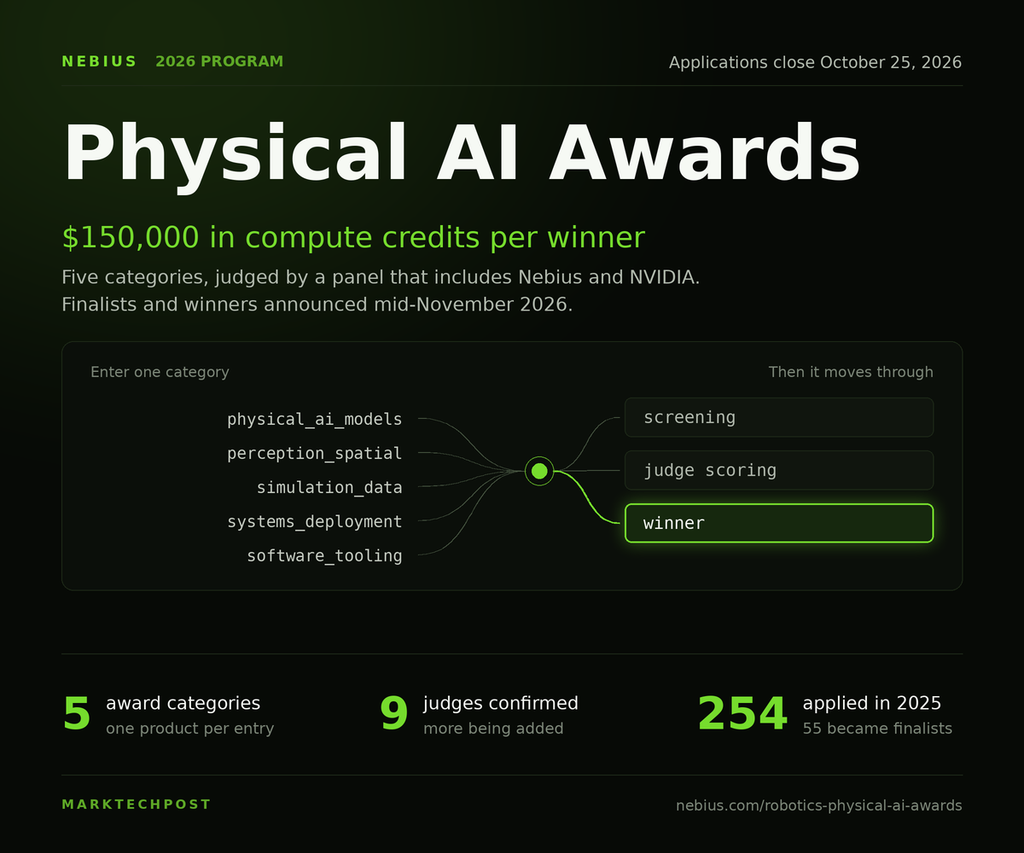
18. Nebius启动2026年实体人工智能奖:设立5个15万美元算力积分大奖[Nebius Opens 2026 Physical AI Awards: Five $150K Compute Credit Prizes]
Nebius 携手英伟达面向全球实体人工智能(Physical AI)领域初创企业启动 2026 年度奖项评选,设立五大赛道并为每个获胜者提供价值 15 万美元的算力积分及全方位生态支持
。
详细内容
- 奖项设置与赋能:评选包含“实体AI模型”、“感知与空间智能”、“仿真与合成数据”、“系统与部署”以及“软件、工具与编排”五大类别;每个类别的获奖者将获得 15 万美元的 Nebius 算力积分、Nebius 与英伟达的双通道联合推广、高管导师指导以及行业专属晚宴席位。
- 具体算力价值量化:Nebius 明确公开了其实例计费标准,15 万美元按按需付费标准约可兑换 38,960 个 H100 GPU 时(约 203 个 8 卡节点天)或 33,330 个 H200 GPU 时(约 174 个 8 卡节点天);若采用可抢占式 H200 实例,算力规模可延展至约 61,200 个 GPU 时,极大满足了强化学习与数据生成需求。
- 评审阵容与申报标准:评审委员会由 Nebius、英伟达团队以及来自 Foxglove、Voxel51、Encord 等产业链基础设施企业的创业者和高管组成;参赛资格要求团队必须具备明确的 Physical AI 落地场景、处于活跃使用或测试阶段的 MVP,并从创新深度、落地广度、市场潜力和现实影响力四个维度进行打分。
- 往届成效与申请周期:该赛事前身在 2025 年吸引了 254 份申请,往届获奖企业如 RoboForce 和 Gather AI 均在后续获得数千万美元的大额融资;2026 年申报通道已开启,截止日期为 2026 年 10 月 25 日,最终获奖名单将于 11 月中旬公布。
亮点:赛事直接将 15 万美元奖金拆解为具体的 GPU 节点天数与机时,且 vCPU 和内存完全打包计费,直击实体 AI 从“算法研发”迈向“规模化硬件部署与训练验证”阶段的真实算力痛点。
19. 谷歌研究院推出 AI 视频联合导演:通过四大智能体框架生成长达数分钟的连贯视频[Google Research Introduces an AI Video Co-Director: 4 Agentic Frameworks for Coherent, Minutes-Long Video Generation]
谷歌研究院推出了一个基于多智能体编排层的 AI 视频联合导演系统,通过四大核心框架解决身份漂移与级联错误,成功实现了长达 10 分钟、高一致性连贯故事视频的生成。
详细内容
- 系统架构与定位:该系统作为模型无关(Model-Agnostic)的编排层运行在 Gemini 和 Veo 之上,无需微调底层生成模型即可协同工作,生成的视频继承基础模型的 SynthID 水印,核心目标是解决长视频流水线中的身份漂移与级联失效问题。
- 四大核心智能体框架:
- Co-Director:引入多臂老虎机(MAB)搜索与 MLLM 裁判打分机制,负责统筹创意策略、分镜制作及音视频子智能体生成。
- CANVAS:构建持久化视觉记忆,在角色或场景重新出现时检索视觉锚点,保持人物、道具与背景的跨镜头一致性。
- A²RD(智能体自回归扩散):免训练架构,通过“检索-合成-细化-更新”闭环,在全新剧情与回归实体间动态切换,支持生成最长达 10 分钟的连续影片。
- VQQA(视频质量问答):通过 VLM 批评充当“语义梯度”重写文本 Prompt,结合全局选择步骤挑选最佳版本,实现无黑盒内部访问的闭环提示词自修正。
- 基准测试与核心数据:谷歌构建了 GenAD-Bench、HardContinuityBench 和 LVBench-C 三大基准。测试显示,Co-Director 在 GenAD-Bench 上斩获 81.4 的平均分;CANVAS 使背景连续性提升 21.6%、角色一致性提升 9.6%;A²RD 在 1 至 10 分钟视频中实现一致性提升最高达 30%、叙事连贯性提升 20%;VQQA 在 T2V-CompBench 上带来 11.57% 的绝对增益。
亮点:整个系统完全免微调(Training-free),将长视频生成重新定义为“全局优化与世界状态追踪”问题,成功打破了以往 AI 生成视频停留在数秒至 1 分钟内的限制,稳定输出长达 10 分钟且人物道具不走样的多镜头连续影片。
AI服务
20. Cohere 发布 Embed 5:全面对比 Voyage 4 Large、Gemini Embedding 2 与 OpenAI
Cohere 发布 Embed 5 嵌入模型家族,分 Pro(追求检索质量)与 Fast(优化在线查询延迟与成本)两档,均支持文本、图像及图文混合输入、100+ 语言、128K 上下文。两档共享同一嵌入空间,可用一档建索引、另一档查询;已在 Cohere API、Model Vault、Microsoft Foundry 与 Amazon SageMaker 上线。
21. Perplexity 发布 pplx-embed-v2-context-9b-preview:一款可同时检索答案与佐证
Perplexity Research 与 turbopuffer 发布 pplx-embed-v2-context-9b-preview:分块嵌入时把整篇文档纳入上下文,训练目标从「命中单一黄金段落」改为「同时取回答案及其佐证」。权重以 MIT 许可放在 Hugging Face,需 transformers≥5.4.0 自托管,尚未上线 Perplexity API。
22. AWS Strands Labs Releases Strands Decider 2B: An Open Source Decision Model That Picks Options in About 115 ms
AWS Strands Labs 发布开源决策模型 Strands Decider 2B:可在约 115 毫秒内从给定选项中做出选择(返回结构化决策而非文本),面向路由、分类等低延迟“有限选项”场景。
23. OpenAI 发布 GPT-6.1 Sol:以 Astra 五分之一的 Token 价格实现接近顶级模型的编程与计算机操作
OpenAI 发布 GPT-6.1 Sol,升级 GPT-6 系列的中端模型:在智能体编程、计算机操作与专业任务上接近 GPT-6 Astra,但输入输出定价仅为 Astra 的五分之一(每百万 token 2/10 美元),缓存输入降至 0.10 美元。已在 API(gpt-6.1-sol)、ChatGPT Work 与 Codex 上线。
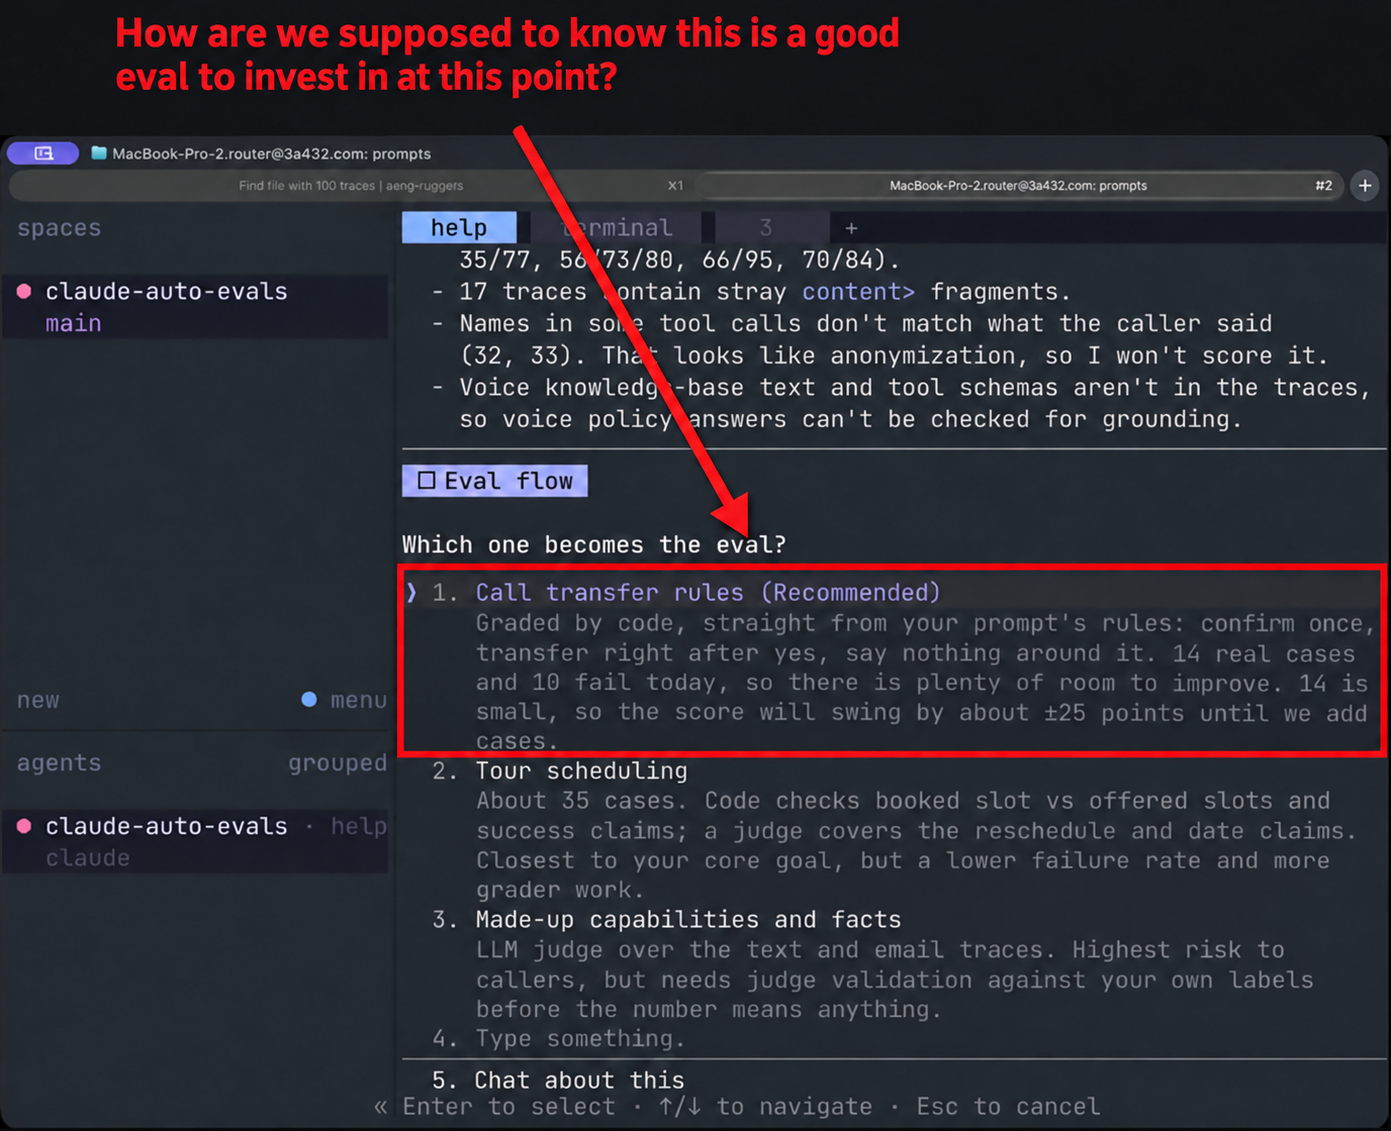
24. Claude’s new auto eval tool
Hamel 试玩 Anthropic 为 Claude Code 新推出的评测工具:claude-api 插件新增 build_eval 与 hill-climb 命令,可构建评测、检查评分器并据此迭代应用。作者记录第一方工具会如何塑造业界对评测的实践方式。
25. Liquid AI 发布 d1:一款零输出 Token 并返回校准概率的决策模型
Liquid AI 发布 d1 决策模型:输入上下文与一组类型化问题,单次调用即返回固定选项上的校准概率,零生成 token。瞄准分类、工单路由、打分、内容审核、重排与 LLM-as-judge 等常被丢给通用大模型的任务;现以托管 API(d1:free)提供,不开放自托管权重。
26. H Company Releases Holo4: Open-Weight Computer-Use Models That Click, Code and Call Tools Across Desktop, Web, Android and APIs
H Company 发布 Holo4:一组开放权重的“计算机使用”Agent 模型(27B 稠密与 35B-A3B MoE 两种规格),通过统一接口操作 GUI、代码、MCP 与 API,覆盖桌面、网页、安卓与 API 场景,并同步更新 Holotron4 Nano。
27. Alibaba Qwen Releases Qwen-Audio-3.1-Realtime: A Full-Duplex Voice Model Trained to Think, Act, and Decide When to Speak
阿里巴巴通义千问发布 Qwen-Audio-3.1-Realtime:一款全双工语音模型,被训练为“会思考、会行动、并自行判断何时该开口说话”,面向实时语音交互场景。
28. Anthropic 发布 Claude Sonnet 5.5:维持 2/10 美元定价且 Terminal-
Anthropic 发布 Claude Sonnet 5.5,Terminal-Bench 4.0 达 70.6%,维持每百万 token 2/10 美元定价。相比 Sonnet 5,输出速度快 30% 以上、单任务成本最多降 30%,定位日常任务、修 bug 与文档/幻灯片生成;已在 Claude Platform 及 AWS、Google Cloud、Azure 上线,闭源不可自托管。
29. 英伟达发布开源智能体安全平台:OpenShell 在 Vera CPU 上实现沙箱隔离,Sentry 在 BlueField-4
英伟达联合 100 多家伙伴推出开放智能体安全平台:OpenShell 安全运行时跑在 Vera CPU 上做沙箱隔离,Sentry 作为 BlueField-4 DPU 上的带外看门狗可在毫秒级隔离异常智能体。核心思路是安全控制不应寄存在它要管控的智能体内部。
资讯地址
https://www.marktechpost.com/2026/09/28/nvidia-launches-open-agent-safety-platform/
(完)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...